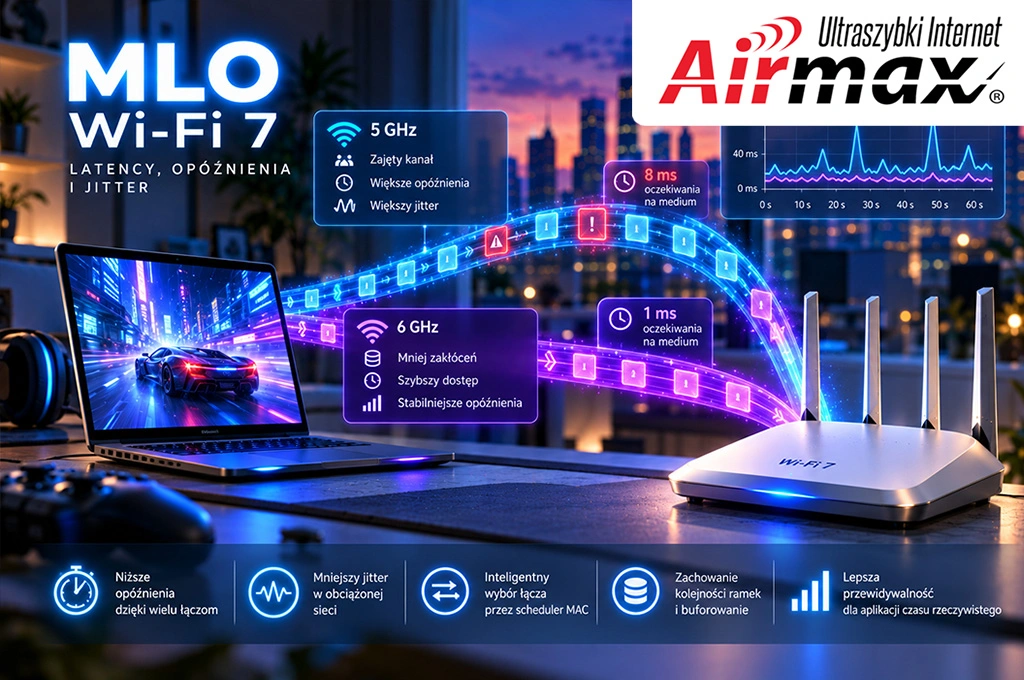
Przepustowość i latencja to dwa różne problemy
Przepustowość opisuje ilość danych, jaką system może skutecznie przesłać w jednostce czasu.
Latencja opisuje natomiast czas potrzebny na dostarczenie określonej jednostki danych od jednego punktu do drugiego.
Te parametry są powiązane, ale nie są tym samym.
Wyobraźmy sobie dwa połączenia.
Pierwsze oferuje bardzo wysoką szybkość PHY, ale przed każdą transmisją urządzenie musi długo czekać na dostęp do kanału.
Drugie pracuje z niższą szybkością PHY, lecz medium jest zwykle dostępne niemal natychmiast.
Dla przesłania dużego pliku pierwsze połączenie może być korzystniejsze.
Dla krótkiej wiadomości sterującej, pakietu gry lub informacji potrzebnej do synchronizacji aplikacji drugie może zapewnić krótszy czas dostarczenia.
Właśnie dlatego zwiększenie szybkości PHY nie przekłada się automatycznie na proporcjonalne zmniejszenie latencji.
Wi-Fi 7 rozwija oba obszary, ale za pomocą różnych mechanizmów.
4096-QAM i kanały 320 MHz zwiększają potencjalną ilość danych przesyłanych w czasie transmisji. MLO może natomiast zmienić sposób, w jaki urządzenie uzyskuje możliwość rozpoczęcia transmisji.
To zasadnicza różnica.
Z czego naprawdę składa się opóźnienie Wi-Fi?
Zanim przejdziemy do MLO, rozłóżmy opóźnienie pojedynczej transmisji na części.
W uproszczonym modelu możemy zapisać:
Ttotal = Tqueue + Taccess + Tairtime + Tprocessing + Trecovery
Gdzie:
- Tqueue to czas oczekiwania ramki w kolejce urządzenia.
- Taccess to czas potrzebny na uzyskanie dostępu do medium radiowego.
- Tairtime to czas transmisji radiowej wraz z odpowiednim narzutem.
- Tprocessing obejmuje przetwarzanie w urządzeniach i warstwie MAC.
- Trecovery reprezentuje dodatkowy czas związany z błędami, ponownymi próbami i innymi procedurami odzyskiwania transmisji.
To model poglądowy, a nie formalna definicja opóźnienia w standardzie IEEE 802.11be. W praktyce poszczególne etapy mogą się częściowo nakładać, a ich granice zależą od sposobu pomiaru.
Najważniejsze jest jednak to, że czas samego nadawania stanowi tylko część całkowitego opóźnienia.
Dla krótkich ramek przesyłanych w obciążonej sieci czas oczekiwania na dostęp do medium może być znacznie większy niż czas właściwej transmisji.
I właśnie tutaj MLO ma szczególnie interesujący potencjał.
Dlaczego jeden kanał tworzy pojedynczy punkt oczekiwania?
Wi-Fi wykorzystuje współdzielone medium radiowe.
Urządzenie nie może zakładać, że w dowolnym momencie ma wyłączne prawo do nadawania. Musi stosować odpowiednie mechanizmy dostępu do kanału, w tym procedury wykrywania zajętości medium i losowego odczekiwania.
W praktyce oznacza to, że nawet ramka gotowa do wysłania może pozostać w kolejce.
Wyobraźmy sobie laptop, który musi przesłać niewielką porcję danych.
Sygnał jest bardzo dobry. Router znajduje się kilka metrów od urządzenia. Możliwa jest transmisja z wysokim MCS.
Jednak w tej samej chwili inne urządzenie korzysta z kanału.
Laptop musi poczekać.
Może się okazać, że właściwa transmisja trwa ułamek milisekundy, a oczekiwanie na jej rozpoczęcie zajmuje kilka milisekund.
W takiej sytuacji zwiększenie szerokości kanału nie rozwiązuje podstawowego problemu.
Nie możemy skrócić czasu oczekiwania na wolne medium samym zwiększeniem szybkości transmisji danych.
Potrzebujemy dodatkowej możliwości dostępu do medium.
MLO: dwa niezależne kanały, dwie możliwości rozpoczęcia transmisji
Załóżmy, że laptop i router obsługują MLO na dwóch łączach:
Link 1: pasmo 5 GHz.
Link 2: pasmo 6 GHz.
Każde łącze ma własne warunki radiowe i własną zajętość medium.
W danym momencie kanał 5 GHz może być obciążony, podczas gdy kanał 6 GHz pozostaje dostępny.
Jeżeli konfiguracja MLO, mapowanie ruchu i możliwości urządzenia pozwalają wykorzystać drugie łącze, transmisja może rozpocząć się bez oczekiwania na zwolnienie pierwszego.
W uproszczonym przypadku, gdy ramka może zostać obsłużona przez dowolne z dwóch dostępnych łączy, czas oczekiwania na możliwość rozpoczęcia transmisji można zilustrować zależnością:
Taccess,MLO ≈ min(Taccess,1, Taccess,2)
To intuicyjny model pokazujący potencjalną korzyść z posiadania dwóch możliwości dostępu do medium.
Nie jest to jednak gwarantowana właściwość każdego trybu MLO. Rzeczywisty wynik zależy między innymi od ograniczeń STR/NSTR, sposobu działania eMLSR, mapowania TID oraz decyzji implementacyjnych.
Mimo tych zastrzeżeń idea jest bardzo ważna.
MLO może ograniczyć czas oczekiwania nie dlatego, że pojedyncza fala radiowa porusza się szybciej, ale dlatego, że urządzenie ma więcej niż jedną możliwość rozpoczęcia transmisji.
Przykład: 8 ms oczekiwania kontra 1 ms
Rozważmy prostą sytuację.
Urządzenie ma do wysłania krótką ramkę danych.
Na kanale 5 GHz przewidywany czas oczekiwania na możliwość transmisji wynosi 8 ms.
Na kanale 6 GHz wynosi 1 ms.
Załóżmy dla uproszczenia, że czas właściwej transmisji i pozostałe narzuty są podobne.
| Parametr | Link 1 – 5 GHz | Link 2 – 6 GHz |
|---|---|---|
| Czas oczekiwania na medium | 8 ms | 1 ms |
| Czas transmisji i obsługi | 0,5 ms | 0,5 ms |
| Łączny czas poglądowy | 8,5 ms | 1,5 ms |
W tym przykładzie skierowanie ramki na drugie łącze pozwala znacząco skrócić czas jej dostarczenia.
Nie oznacza to jednak, że MLO zawsze redukuje latencję o określony procent.
Przykład pokazuje jedynie, jak duże znaczenie może mieć różnica w czasie dostępu do medium.
Co więcej, wartości te nie są stałe.
Po kilku milisekundach sytuacja może się odwrócić: kanał 6 GHz stanie się zajęty, a 5 GHz będzie dostępny.
Dlatego najważniejszą cechą MLO jest elastyczność wyboru, a nie przypisanie jednemu pasmu roli zawsze szybszego kanału.
Dlaczego średnie opóźnienie nie mówi całej prawdy?
Wiele testów sieciowych pokazuje jedną wartość latencji, na przykład średni czas odpowiedzi.
To przydatna informacja, ale może ukrywać zachowanie, które użytkownik odczuwa najbardziej.
Wyobraźmy sobie dwa połączenia.
Pierwsze przez większość czasu dostarcza dane w 4 ms, ale sporadycznie opóźnienie rośnie do 80 ms.
Drugie zwykle dostarcza dane w 7–10 ms, bez równie dużych skoków.
Średnie opóźnienie pierwszego połączenia może wyglądać atrakcyjnie.
Jednak w grze online, rozmowie głosowej lub systemie sterowania pojedynczy duży skok może być bardziej problematyczny niż kilka dodatkowych milisekund stałego opóźnienia.
Dlatego przy ocenie MLO warto analizować nie tylko średnią, lecz także rozkład opóźnień.
Szczególnie istotne są wysokie percentyle, takie jak 95. i 99. percentyl.
P99 latency oznacza wartość, poniżej której mieści się 99% zmierzonych opóźnień w danym zbiorze próbek.
Jeżeli P99 jest znacznie wyższe od mediany, oznacza to, że niewielka część transmisji doświadcza dużo większych opóźnień.
W praktyce właśnie te rzadkie zdarzenia mogą decydować o odczuwalnej jakości aplikacji czasu rzeczywistego.
Jitter: dlaczego nieregularność bywa gorsza od samego opóźnienia?
Jitter opisuje zmienność opóźnienia w czasie.
Dla aplikacji przesyłających dane w regularnych odstępach, takich jak transmisja głosu czy obrazu na żywo, ważne jest nie tylko to, jak szybko dane docierają, ale również jak przewidywalnie się to dzieje.
Załóżmy, że aplikacja generuje porcję danych co 10 ms.
Jeżeli kolejne porcje docierają po 5, 6, 5 i 7 ms, odbiornik może stosunkowo łatwo utrzymać płynność działania.
Jeżeli natomiast opóźnienia wynoszą 2, 3, 35 i 4 ms, problem staje się trudniejszy.
Jedna porcja danych dociera znacznie później niż pozostałe.
MLO może pomagać w ograniczaniu takich skoków, ponieważ umożliwia wykorzystanie alternatywnego łącza, gdy jedno medium jest chwilowo niedostępne.
Ale istnieje również druga strona tego mechanizmu.
Jeżeli urządzenie rozdziela kolejne ramki pomiędzy łącza o bardzo różnych czasach obsługi, może zwiększyć różnice pomiędzy momentami ich dostarczenia.
To oznacza, że MLO może ograniczać jitter wynikający z zajętości medium, a jednocześnie w pewnych warunkach wprowadzać dodatkową zmienność związaną z koordynacją wielu łączy.
Wszystko zależy od sposobu zarządzania ruchem.
Gdy szybsza ramka czeka na wolniejszą
W poprzednim artykule omawialiśmy problem kolejności ramek i mechanizm reordering.
Teraz zobaczmy go z perspektywy latencji.
Załóżmy, że urządzenie przygotowuje dwie kolejne jednostki danych należące do tej samej sekwencji.
Ramka A zostaje skierowana na Link 1.
Ramka B zostaje skierowana na Link 2.
Link 2 szybko uzyskuje dostęp do medium i dostarcza ramkę B.
Tymczasem ramka A napotyka zakłócenie i wymaga retransmisji.
Odbiornik może więc poprawnie odebrać B, zanim dotrze A.
Jeżeli zasady przetwarzania tej sekwencji wymagają zachowania kolejności, B może oczekiwać w buforze reorganizacji ramek.
W rezultacie czas poprawnego odbioru radiowego nie musi być równy czasowi przekazania danych dalej.
Możemy to przedstawić jako:
Tdelivery = Tradio + Treordering
W tym uproszczonym modelu Treordering oznacza dodatkowy czas związany z oczekiwaniem na możliwość przekazania danych we właściwym porządku.
Jeżeli nie ma takiej potrzeby, ten składnik może być zerowy.
Jeżeli wcześniejsza jednostka danych jest opóźniona, czas oczekiwania może wzrosnąć.
To ważny paradoks: ramka może dotrzeć przez radio bardzo szybko, a mimo to zostać udostępniona kolejnemu etapowi przetwarzania później niż oczekiwano.
Head-of-line blocking w systemie wielołączowym
Zjawisko, w którym wcześniejsza jednostka danych opóźnia obsługę kolejnych, wiąże się z pojęciem head-of-line blocking.
W MLO jego znaczenie zależy od organizacji kolejek, TID, numeracji sekwencyjnej i mechanizmów odbiorczych.
Nie oznacza to, że wszystkie ramki wszystkich aplikacji muszą czekać na jedną wspólną sekwencję.
Jednak w obrębie odpowiednio uporządkowanego strumienia brakująca jednostka danych może opóźniać dalsze przekazywanie innych.
Załóżmy, że Link 1 ma niestabilne warunki radiowe i wymaga częstych retransmisji.
Link 2 działa bardzo dobrze.
Jeżeli algorytm regularnie rozdziela kolejne ramki tej samej sekwencji pomiędzy oba łącza, szybkie dostarczanie części danych przez Link 2 nie musi w pełni przełożyć się na równie szybkie przekazywanie ich dalej.
W skrajnym przypadku wolniejsze łącze może wpływać na opóźnienie całego uporządkowanego strumienia.
Dlatego dobry mechanizm rozdzielania ruchu powinien uwzględniać nie tylko moment zakończenia transmisji na danym kanale, ale również wpływ tej decyzji na późniejsze przetwarzanie ramek.
Dlaczego dwa niezależne kanały nie zawsze są naprawdę niezależne?
Do tej pory zakładaliśmy, że oba łącza mogą pracować niezależnie.
W rzeczywistym urządzeniu nie zawsze jest to prawdą.
W konfiguracji STR (Simultaneous Transmit and Receive) odpowiednia architektura sprzętowa pozwala realizować określone operacje nadawania i odbioru równocześnie na różnych łączach.
Takie możliwości sprzyjają niezależnemu wykorzystaniu kanałów.
Jednak w konfiguracjach NSTR (Non-Simultaneous Transmit and Receive) występują ograniczenia dotyczące niektórych kombinacji jednoczesnego nadawania i odbioru.
Ich przyczyną mogą być na przykład sprzężenia pomiędzy torami RF i zakłócanie własnego odbiornika przez nadajnik.
W efekcie aktywność jednego łącza może ograniczać możliwości drugiego.
To istotne dla latencji.
Nawet jeżeli drugi kanał radiowy jest wolny, urządzenie może nie być w stanie natychmiast wykorzystać go do określonej operacji.
Dostępność kanału w eterze nie jest tym samym co dostępność zasobów radiowych wewnątrz urządzenia.
Właśnie dlatego dwa łącza MLO nie zawsze zachowują się jak dwa całkowicie niezależne systemy transmisyjne.
eMLSR: więcej możliwości, ale również koszt przełączania
Szczególnie ciekawym przypadkiem jest Enhanced Multi-Link Single Radio (eMLSR).
Mechanizm ten pozwala urządzeniu korzystać z możliwości wielu łączy bez konieczności utrzymywania pełnej, niezależnej zdolności transmisji danych na wszystkich z nich jednocześnie.
W praktyce wymaga odpowiedniej koordynacji monitorowania łączy i przełączania zasobów radiowych.
To atrakcyjne rozwiązanie dla urządzeń, w których liczą się koszt, rozmiar i pobór energii.
Jednak z punktu widzenia latencji pojawia się dodatkowy składnik.
Jeżeli urządzenie musi przełączyć aktywną obsługę transmisji pomiędzy łączami, operacja ta nie jest całkowicie darmowa.
Może wymagać czasu oraz odpowiedniej synchronizacji z procedurami MAC.
W uproszczeniu:
Ttotal = Taccess + Tairtime + Tswitch + Tother
Gdzie Tswitch reprezentuje dodatkowy koszt związany z przełączeniem zasobów radiowych, jeśli dana operacja go wymaga.
Nie oznacza to, że eMLSR musi mieć wyższe opóźnienie niż tradycyjne Wi-Fi.
Oznacza natomiast, że potencjalna korzyść z wyboru mniej obciążonego kanału musi być zestawiona z kosztem wykorzystania tego kanału.
Jeżeli różnica w czasie oczekiwania wynosi kilka milisekund, przełączenie może być opłacalne.
Jeżeli korzyść jest bardzo mała, dodatkowa operacja może ograniczyć lub zniwelować zysk.
Scheduler MLO nie może patrzeć wyłącznie na zajętość kanału
W poprzednim artykule omawialiśmy mechanizmy rozdzielania ramek pomiędzy łącza.
Teraz możemy doprecyzować, co oznacza dobra decyzja z punktu widzenia opóźnienia.
Załóżmy, że Link 1 jest aktualnie zajęty, ale za chwilę prawdopodobnie stanie się dostępny.
Link 2 jest wolny, lecz jego wykorzystanie wymaga przełączenia zasobów radiowych.
Prosty algorytm mógłby natychmiast wybrać Link 2.
Bardziej zaawansowany mechanizm powinien uwzględnić przewidywany czas zakończenia całej operacji.
Możemy zdefiniować poglądową funkcję kosztu:
Ci = Tqueue,i + Taccess,i + Tairtime,i + Tswitch,i + Trisk,i
Ostatni składnik reprezentuje szacowany koszt wynikający z ryzyka błędów i retransmisji.
W takim modelu korzystniejsze jest łącze o niższym przewidywanym koszcie całkowitym, a niekoniecznie to, które w danej chwili wygląda na najszybsze.
Oczywiście rzeczywiste implementacje nie muszą wykorzystywać dokładnie takiego równania.
Producenci mogą stosować różne algorytmy, heurystyki i mechanizmy oceny warunków radiowych.
Istotna pozostaje sama zasada: minimalizacja latencji wymaga oceny czasu dostarczenia danych, a nie tylko parametrów PHY.
Retransmisje: największy wróg przewidywalnego czasu dostarczenia
Wi-Fi działa w środowisku, w którym błędy transmisji są naturalnym elementem komunikacji.
Zakłócenia, chwilowe zaniki sygnału, kolizje i zmiany warunków propagacyjnych mogą powodować konieczność ponownego wysłania ramek.
Retransmisja zwiększa opóźnienie.
Nie tylko dlatego, że dane muszą zostać ponownie nadane.
Urządzenie może również potrzebować kolejnej okazji do uzyskania dostępu do medium.
W rezultacie pojedyncza nieudana transmisja może wywołać opóźnienie znacznie większe niż czas trwania samej ramki.
MLO może zwiększyć elastyczność obsługi takich sytuacji, ponieważ dostępne są różne łącza radiowe.
Nie oznacza to jednak, że każda nieudana ramka automatycznie zostanie natychmiast przesłana drugim kanałem.
Możliwości retransmisji zależą od zasad MAC, mapowania TID, dostępności łączy i konfiguracji urządzenia.
Ważne jest również to, że drugi kanał może być obciążony albo mieć gorsze warunki transmisji.
Dlatego sama obecność alternatywnego łącza nie gwarantuje krótszego czasu odzyskiwania po błędzie.
Dlaczego 6 GHz nie zawsze zapewnia niższą latencję?
Pasmo 6 GHz jest często kojarzone z dużą szerokością kanałów i możliwością pracy w mniej zatłoczonym środowisku radiowym.
W wielu sytuacjach może to być istotna zaleta.
Nie oznacza to jednak, że 6 GHz z definicji zapewnia niższe opóźnienie niż 5 GHz.
Warunki zależą od otoczenia, liczby aktywnych urządzeń, odległości, przeszkód oraz obowiązujących zasad wykorzystania pasma.
Sygnał 6 GHz może mieć inne właściwości propagacyjne niż sygnał 5 GHz.
W pewnych warunkach łącze 6 GHz może pracować z niższym MCS albo wymagać większej liczby retransmisji.
Jeżeli kanał 5 GHz oferuje stabilniejszą transmisję i krótszy czas oczekiwania, może zapewnić niższą latencję mimo mniejszej szerokości pasma.
W MLO najważniejsze jest więc to, że urządzenie może korzystać z różnych właściwości łączy.
Nie powinno natomiast zakładać, że jedno pasmo zawsze wygrywa.
QoS i TID-to-Link Mapping: nie każda ramka ma ten sam priorytet
Nie wszystkie aplikacje mają takie same wymagania.
Pobieranie dużego pliku zwykle korzysta przede wszystkim z wysokiej przepustowości.
Rozmowa głosowa potrzebuje regularnego dostarczania niewielkich porcji danych.
Gra online może być szczególnie wrażliwa na nagłe skoki opóźnienia.
W Wi-Fi mechanizmy Quality of Service (QoS) pozwalają różnicować obsługę ruchu.
W architekturze MLO istotną rolę odgrywa również TID-to-Link Mapping, które określa, na jakich łączach może być obsługiwany ruch związany z określonym TID.
To daje możliwość odpowiedniego organizowania wykorzystania łączy.
Jednak mapowanie TID nie oznacza automatycznie, że każda aplikacja otrzymuje własny dedykowany kanał.
Nie gwarantuje również określonego czasu dostarczenia danych.
Rzeczywisty efekt zależy od konfiguracji QoS, obciążenia sieci, możliwości urządzeń i algorytmów zarządzania ruchem.
MLO zwiększa elastyczność obsługi różnych rodzajów transmisji, ale nie zamienia współdzielonego medium radiowego w deterministyczne łącze o gwarantowanym opóźnieniu.
Czy MLO może pogorszyć latencję względem jednego łącza?
Tak, w określonych warunkach jest to możliwe.
Wyobraźmy sobie urządzenie, które ma bardzo dobre i stabilne połączenie na jednym kanale.
Drugi kanał działa gorzej, częściej wymaga retransmisji i ma większą zmienność czasu dostępu do medium.
Jeżeli algorytm rozdzielania ruchu kieruje część wrażliwych na opóźnienie ramek na mniej przewidywalne łącze, może zwiększyć czas dostarczenia niektórych danych.
Jeżeli dodatkowo występuje konieczność reorganizacji kolejności ramek, opóźnienie może wzrosnąć również po ich poprawnym odebraniu.
W konfiguracjach wymagających przełączania zasobów radiowych dochodzi kolejny możliwy narzut.
Nie jest to dowód, że MLO jest rozwiązaniem nieefektywnym.
To raczej pokazuje, że większa liczba dostępnych ścieżek transmisji zwiększa potencjał optymalizacji, ale nie gwarantuje, że każda decyzja będzie optymalna.
Dobrze zaprojektowany system powinien umieć również ograniczyć wykorzystanie łącza, które w danej sytuacji nie przynosi korzyści.
Dlaczego test ping nie wystarcza do oceny MLO?
Najprostszym sposobem sprawdzania opóźnienia sieci jest wykonanie testu ping.
Może on dostarczyć przydatnych informacji, ale nie pokazuje całego zachowania MLO.
Ping mierzy czas odpowiedzi dla określonego ruchu, obejmując nie tylko transmisję Wi-Fi, lecz także inne elementy ścieżki sieciowej.
Jeżeli testujemy połączenie z odległym serwerem internetowym, wynik może być zdominowany przez opóźnienia poza siecią bezprzewodową.
Wtedy różnice wynikające z MLO mogą być trudne do zauważenia.
Aby lepiej ocenić wpływ MLO na latencję, warto porównywać warunki możliwie podobne, na przykład przy pomiarach do urządzenia w tej samej sieci lokalnej.
Istotne jest również obciążenie kanałów.
W prawie pustej sieci jedno stabilne łącze może zapewniać bardzo małe opóźnienia, a drugie nie wniesie dużej korzyści.
W obciążonym środowisku różnice mogą być bardziej widoczne.
Dlatego sensowny test powinien obejmować nie tylko średnią, ale również medianę, wysokie percentyle, jitter i liczbę utraconych pakietów.
Warto też sprawdzić, czy podczas pomiaru MLO rzeczywiście było aktywne i w jaki sposób urządzenia wykorzystywały dostępne łącza.
Bez tego łatwo przypisać MLO efekt, który w rzeczywistości wynika z innych czynników.
Latencja zależy od całego systemu, nie tylko od radia
Warto pamiętać, że Wi-Fi jest tylko jednym z elementów ścieżki komunikacyjnej.
Opóźnienie może powstawać w sterowniku, firmware, kolejkach systemu operacyjnego, routerze, sieci przewodowej i urządzeniu docelowym.
MLO może wpływać na radiowy fragment tej ścieżki oraz związane z nim operacje MAC.
Nie usuwa jednak opóźnień występujących poza tym obszarem.
Jeżeli głównym problemem jest przeciążone łącze internetowe, słabo działający serwer albo nadmierne buforowanie na innym urządzeniu, samo uruchomienie MLO nie musi przynieść zauważalnej poprawy.
Dlatego oceniając Wi-Fi 7, trzeba oddzielać korzyści wynikające z warstwy radiowej od zachowania całej sieci.
Niska latencja nie jest właściwością samego standardu radiowego. Jest wynikiem współpracy wszystkich elementów systemu transmisyjnego.
Największą korzyścią MLO może być przewidywalność
W marketingowych opisach Wi-Fi 7 często podkreśla się wzrost przepustowości.
Jednak z punktu widzenia aplikacji czasu rzeczywistego równie interesująca może być możliwość ograniczenia niektórych skoków opóźnienia.
Jeżeli jeden kanał staje się chwilowo niedostępny, drugi może zaoferować alternatywną okazję do transmisji.
To może pomóc szczególnie w środowiskach, w których obciążenie medium zmienia się dynamicznie.
Ale aby uzyskać taki efekt, urządzenie musi właściwie zarządzać kolejkami, dostępnością łączy, retransmisjami i kolejnością ramek.
Musi również uwzględniać ograniczenia sprzętowe.
Wtedy MLO staje się czymś więcej niż mechanizmem zwiększania przepustowości.
Staje się narzędziem zarządzania ryzykiem opóźnienia.
Nie gwarantuje, że każda ramka dotrze szybciej.
Może jednak zwiększyć szansę, że urządzenie znajdzie korzystniejszą możliwość transmisji w chwili, gdy jest ona potrzebna.
Dwa kanały nie rozwiązują problemu czasu — dają więcej możliwości jego kontrolowania
Najważniejsza różnica pomiędzy tradycyjnym Wi-Fi a MLO nie polega na tym, że druga technologia potrafi zawsze nadawać dwa razy szybciej.
Polega na tym, że system nie musi już opierać wszystkich decyzji transmisyjnych na jednym łączu.
Może korzystać z różnych warunków zajętości medium, różnych parametrów radiowych i różnych możliwości dostępu do kanału.
To otwiera drogę do zmniejszania opóźnień, ograniczania części retransmisji i poprawy przewidywalności działania sieci.
Jednocześnie pojawiają się nowe koszty: koordynacja, przełączanie zasobów radiowych, buforowanie oraz reorganizacja kolejności ramek.
Dlatego MLO może zmniejszyć latencję, ale nie robi tego automatycznie.
Korzyść wynika z jakości decyzji podejmowanych przez cały system MAC i RF.
I właśnie to prowadzi nas do kolejnego pytania.
Skoro urządzenia Wi-Fi 7 mogą obsługiwać kilka łączy, to czy wszystkie muszą pracować w tym samym czasie?
A może czasami lepiej pozwolić im działać niezależnie, nawet kosztem dodatkowej koordynacji?
W następnym artykule przyjrzymy się dwóm różnym sposobom organizacji pracy wielu łączy:
Synchronous czy Asynchronous MLO? Dwa różne sposoby myślenia o wielu linkach.
Zobaczymy, jak synchronizacja wpływa na dostęp do medium, architekturę RF, ograniczenia sprzętowe i rzeczywiste możliwości Wi-Fi 7.