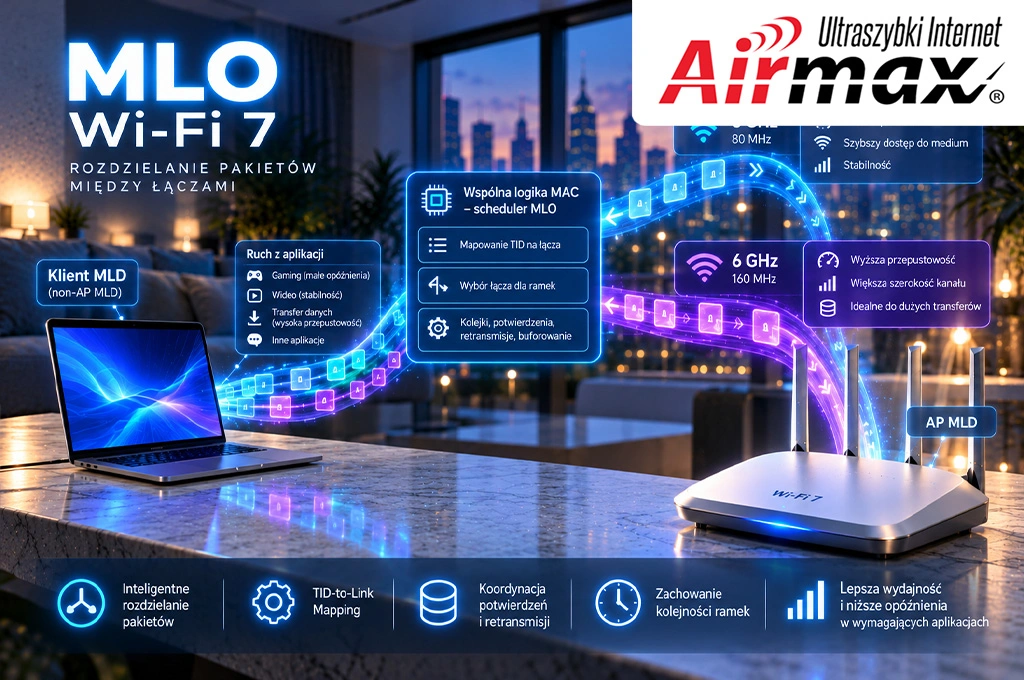
Dwa kanały nie oznaczają dwóch identycznych ścieżek
Wyobraźmy sobie laptop obsługujący Wi-Fi 7, połączony z routerem przez dwa łącza:
Link 1 działa w paśmie 5 GHz, wykorzystując kanał o szerokości 80 MHz.
Link 2 działa w paśmie 6 GHz, wykorzystując kanał o szerokości 160 MHz.
Na pierwszy rzut oka drugi kanał wygląda atrakcyjniej. Ma dwukrotnie większą szerokość pasma, więc przy porównywalnych pozostałych parametrach może zaoferować wyższą szybkość transmisji.
Ale to tylko część obrazu.
Sygnał 6 GHz może być silniej tłumiony przez przeszkody. Urządzenie może pracować na innym MCS, a dostęp do medium może być chwilowo ograniczony.
Tymczasem kanał 5 GHz, mimo mniejszej szerokości, może być akurat wolny i gotowy do transmisji.
Powstaje więc pytanie: czy lepiej wybrać kanał o wyższej maksymalnej przepustowości, czy ten, który pozwoli rozpocząć transmisję wcześniej?
Odpowiedź zależy od rodzaju ruchu, aktualnych warunków i możliwości sprzętu.
To pierwszy powód, dla którego MLO potrzebuje mechanizmów podejmowania decyzji, a nie prostego dzielenia pakietów po równo.
Co właściwie rozdzielamy: pakiety IP czy ramki Wi-Fi?
Warto uporządkować pojęcia.
Gdy aplikacja wysyła dane, przechodzą one przez kolejne warstwy stosu sieciowego. Pakiet IP nie jest bezpośrednio tym samym obiektem, który zostaje wyemitowany przez antenę.
Warstwa MAC Wi-Fi przygotowuje jednostki danych do transmisji, zarządza ich numeracją, agregacją, potwierdzeniami i retransmisjami.
Dlatego w kontekście MLO bardziej precyzyjnie jest mówić o kierowaniu ruchu i ramek MAC na poszczególne łącza niż o mechanicznym rozcinaniu pakietów IP.
W architekturze Multi-Link Device (MLD) część funkcji MAC może być wspólna dla kilku łączy, podczas gdy inne operacje pozostają związane z konkretnym radiem.
To rozdzielenie ma fundamentalne znaczenie.
Gdyby każde radio działało całkowicie niezależnie, system musiałby później scalać dwie osobne komunikacje.
MLO projektowano natomiast tak, aby kilka łączy mogło funkcjonować w ramach jednej logicznej relacji pomiędzy AP MLD a non-AP MLD.
Wspólny MAC i osobne mechanizmy dostępu do medium
Wyobraźmy sobie uproszczoną architekturę urządzenia MLD.
Na górze znajduje się wspólna logika zarządzająca ruchem. Poniżej działają dwa zestawy funkcji obsługujących poszczególne łącza radiowe.
Schematycznie:
Ruch, numeracja sekwencyjna, mapowanie TID, koordynacja
Dostęp do medium, transmisja PHY, potwierdzenia
Dostęp do medium, transmisja PHY, potwierdzenia
To model poglądowy, a nie kompletny schemat implementacji standardu IEEE 802.11be.
Najważniejsza jest różnica pomiędzy wspólnym zarządzaniem komunikacją a lokalną obsługą konkretnego kanału radiowego.
Każde łącze nadal musi przestrzegać reguł dostępu do medium. Wspólna logika MLD nie może po prostu nakazać radiu nadawania na zajętym kanale.
Może natomiast decydować, jak wykorzystać dostępne możliwości poszczególnych łączy.
Dlaczego prosty podział 50/50 nie działa?
Załóżmy, że urządzenie ma do wysłania 100 ramek danych.
Najprostszy algorytm mógłby skierować 50 ramek na pierwsze łącze i 50 na drugie.
Taki podział byłby sensowny tylko przy założeniu, że oba kanały oferują porównywalną przepustowość, podobne opóźnienia i podobne prawdopodobieństwo retransmisji.
W rzeczywistej sieci te warunki rzadko są spełnione przez dłuższy czas.
Przykładowo:
| Parametr | Link 1 | Link 2 |
|---|---|---|
| Pasmo | 5 GHz | 6 GHz |
| Szerokość kanału | 80 MHz | 160 MHz |
| Poglądowa szybkość PHY | 600 Mb/s | 1200 Mb/s |
| Chwilowy czas oczekiwania | 1 ms | 7 ms |
Wartości są ilustracyjne i nie opisują konkretnej konfiguracji MCS ani liczby spatial streams.
Jeżeli chcemy przesłać dużą ilość danych, drugi kanał może być bardzo wartościowy ze względu na wyższą szybkość PHY.
Jeżeli jednak musimy natychmiast wysłać małą ramkę, pierwszy kanał może zapewnić wcześniejsze rozpoczęcie transmisji.
Właśnie dlatego algorytm rozdzielania ruchu musi brać pod uwagę więcej niż samą nominalną przepustowość.
Kolejka nie mówi nam, kiedy kanał będzie dostępny
Jednym z najbardziej podstępnych problemów Wi-Fi jest to, że czas oczekiwania na transmisję nie jest stały.
W sieci przewodowej o kontrolowanym obciążeniu możemy stosunkowo łatwo oszacować czas potrzebny na wysłanie określonej ilości danych.
W Wi-Fi urządzenie musi uwzględniać zajętość medium, procedury backoff, kolizje i retransmisje.
Co ważne, kanał, który jest wolny w chwili podjęcia decyzji, może zostać zajęty zanim rozpocznie się transmisja.
Podobnie kanał uznany za obciążony może za moment stać się dostępny.
Dlatego decyzja o wyborze łącza opiera się na informacji, która jest z natury niepełna i szybko się starzeje.
Możemy zapisać poglądowy model czasu obsługi ramki na łączu i:
Ti = Tqueue,i + Taccess,i + Tairtime,i + Tretry,i
Gdzie:
- Tqueue,i oznacza czas oczekiwania w kolejce,
- Taccess,i oznacza czas uzyskania dostępu do medium,
- Tairtime,i oznacza czas właściwej transmisji,
- Tretry,i reprezentuje dodatkowy koszt ewentualnych retransmisji.
Nie jest to równanie definiujące mechanizm standardu, lecz użyteczny model inżynierski.
Pokazuje, dlaczego łącze o wyższym PHY rate nie zawsze zapewni krótszy czas dostarczenia danych.
TID: nie każdy rodzaj ruchu musi korzystać z tych samych łączy
Wi-Fi rozróżnia klasy ruchu o różnych wymaganiach.
W mechanizmach QoS wykorzystywane są identyfikatory Traffic Identifier (TID), powiązane z obsługą określonych kategorii ruchu.
MLO wprowadza możliwość mapowania TID na dostępne łącza, określaną jako TID-to-Link Mapping.
To istotny element całej architektury.
Nie musimy zakładać, że każdy rodzaj ruchu może być kierowany dowolnie na wszystkie łącza w każdej chwili.
Zależnie od wynegocjowanej konfiguracji określony TID może być obsługiwany przez wskazany zbiór łączy.
Przykładowo system może wykorzystywać inne możliwości dla ruchu wrażliwego na opóźnienia, a inne dla transmisji dużych ilości danych.
Nie oznacza to jednak, że standard narzuca jeden uniwersalny algorytm, który zawsze wysyła gry przez 5 GHz, a pobieranie plików przez 6 GHz.
Takie decyzje zależą od konfiguracji, polityki zarządzania ruchem i możliwości urządzeń.
TID-to-Link Mapping określa, gdzie dany ruch może być obsługiwany. Nie jest tym samym co algorytm przewidujący najlepsze łącze dla każdej ramki.
Dwa kanały, dwie różne osie czasu
Teraz przejdźmy do problemu, który pokazuje, dlaczego MLO wymaga wspólnej koordynacji.
Załóżmy, że urządzenie chce wysłać cztery kolejne ramki:
A, B, C i D.
Ramki A i C zostają skierowane na Link 1, natomiast B i D na Link 2.
Link 1 jest chwilowo zajęty. Link 2 uzyskuje dostęp do medium szybciej.
W rezultacie odbiornik może otrzymać ramki w kolejności:
B → D → A → C
Chociaż urządzenie nadawcze przygotowało je w kolejności:
A → B → C → D
To przykład poglądowy. Konkretne zasady numeracji i przetwarzania ramek zależą od rodzaju ruchu oraz mechanizmów MAC.
Najważniejsze jest to, że kolejność zakończenia transmisji na dwóch niezależnych łączach nie musi odpowiadać kolejności przygotowania danych.
Przykładowa kolejność dostarczenia ramek
| Łącze | Wcześniej | Później | ||
|---|---|---|---|---|
| Link 1 | — | — | A | C |
| Link 2 | B | D | — | — |
Link 2 kończy transmisje B i D wcześniej, mimo że ramki A i C zostały przygotowane w tej samej sekwencji danych.
To prowadzi do pytania: jak odbiornik ma zachować poprawną kolejność przetwarzania danych?
Numery sekwencyjne: skąd odbiornik wie, czego brakuje?
Warstwa MAC Wi-Fi wykorzystuje mechanizmy numeracji sekwencyjnej, które pomagają identyfikować ramki, duplikaty oraz brakujące jednostki danych.
W MLO szczególne znaczenie ma wspólna obsługa numeracji dla odpowiedniego ruchu przesyłanego przez różne łącza.
Dzięki temu odbiornik może rozpoznawać, które jednostki danych należą do tej samej logicznej sekwencji, nawet jeśli zostały odebrane na różnych kanałach.
Wyobraźmy sobie, że odbiornik otrzymuje kolejno ramki o numerach:
101, 103, 104
Brakuje ramki 102.
Odbiornik nie powinien automatycznie zakładać, że dane są poprawnie uporządkowane tylko dlatego, że wszystkie otrzymane ramki zostały odebrane bez błędów radiowych.
Ramka 102 może być jeszcze w transmisji na drugim łączu albo wymagać retransmisji.
Odpowiednie mechanizmy MAC pozwalają obsłużyć taką sytuację.
Nie należy jednak utożsamiać numerów sekwencyjnych MAC z numerami sekwencyjnymi TCP. Są to różne poziomy protokołu, rozwiązujące inne problemy.
Block Ack: potwierdzenia bez osobnego ACK dla każdej ramki
W nowoczesnym Wi-Fi efektywność transmisji zależy między innymi od agregacji ramek i mechanizmu Block Acknowledgment (Block Ack).
Zamiast potwierdzać każdą jednostkę danych osobną wymianą, odbiornik może przekazać informację o stanie odbioru wielu jednostek w ramach odpowiedniej procedury.
W przypadku MLO koordynacja potwierdzeń i buforowania staje się bardziej złożona, ponieważ ruch związany z jedną logiczną komunikacją może korzystać z różnych łączy.
System musi prawidłowo rozpoznawać odebrane jednostki danych i zarządzać tymi, które wymagają ponownej transmisji.
Istotne jest również to, że retransmisja nie zawsze musi być traktowana jako powtórzenie na dokładnie tej samej fizycznej ścieżce. Możliwości wykorzystania łączy zależą od odpowiednich zasad MAC, mapowania ruchu i bieżącej konfiguracji.
To kolejny powód, dla którego MLO wymaga wspólnego zarządzania stanem transmisji.
Bez takiej koordynacji dwa niezależne radia nie wiedziałyby wystarczająco dużo o tym, które dane zostały już skutecznie dostarczone w ramach wspólnej komunikacji.
Reordering: kiedy szybszy kanał musi poczekać na wolniejszy
Rozważmy sytuację, w której na Link 1 przesyłana jest ramka A, a na Link 2 ramka B.
Ramka B dociera poprawnie, ale A wymaga retransmisji.
Jeżeli obie należą do sekwencji, dla której odbiornik musi zachować odpowiedni porządek, B może zostać zatrzymana w buforze do czasu uzupełnienia brakujących danych albo zastosowania właściwych reguł przesunięcia okna odbiorczego.
To zjawisko jest szczególnie ważne, ponieważ pokazuje paradoks transmisji wielołączowej.
Szybsze dostarczenie części ramek nie musi oznaczać szybszego przekazania całego strumienia danych do kolejnego etapu przetwarzania.
W uproszczeniu możemy wyróżnić dwa czasy:
Tradio — moment poprawnego odbioru ramki przez radio.
Tdelivery — moment, w którym ramka może zostać przekazana dalej po odpowiednim przetworzeniu MAC.
Nie zawsze są one równe.
Jeżeli występuje konieczność uporządkowania danych, możemy mieć:
Tdelivery ≥ Tradio
Różnica wynika między innymi z buforowania i oczekiwania na brakujące jednostki danych.
To właśnie dlatego projektant MLO nie może optymalizować wyłącznie szybkości pojedynczego kanału.
Musi uwzględniać również konsekwencje dla całej sekwencji transmisji.
Head-of-line blocking: gdy jedna ramka zatrzymuje pozostałe
Problem oczekiwania na brakujące dane wiąże się z szerszym zjawiskiem znanym jako head-of-line blocking (HOL blocking).
W ogólnym sensie występuje ono wtedy, gdy element znajdujący się wcześniej w kolejności przetwarzania opóźnia obsługę kolejnych elementów.
W systemie wielołączowym może dojść do sytuacji, w której jedna ramka przesyłana przez wolniejsze lub chwilowo niedostępne łącze opóźnia dalsze przekazanie innych ramek.
Nie oznacza to, że każdy ruch MLO zawsze podlega jednemu globalnemu blokowaniu. Znaczenie mają TID, zasady porządkowania oraz organizacja buforów.
Pokazuje to jednak istotną zależność.
Jeżeli algorytm rozdzielania ruchu zbyt agresywnie wykorzystuje łącze o niestabilnych warunkach, może zwiększyć zmienność czasu dostarczenia danych.
A wtedy dodatkowe łącze, które miało poprawić wydajność, może stać się źródłem dodatkowych opóźnień.
Czy można po prostu wysyłać wszystko przez szybszy kanał?
Takie podejście wydaje się rozsądne, ale wymaga odpowiedzi na pytanie: co właściwie znaczy „szybszy”?
Możemy mierzyć aktualny PHY rate, średnią przepustowość, poziom zajętości medium, liczbę retransmisji albo przewidywany czas zakończenia transmisji.
Każda z tych miar opisuje nieco inny aspekt działania kanału.
Łącze o wysokim PHY rate może mieć długie okresy oczekiwania.
Łącze o niższym PHY rate może zapewniać bardziej przewidywalny dostęp do medium.
Kanał o bardzo dobrym SNR może być obciążony ruchem innych urządzeń.
Dlatego sama informacja o modulacji, szerokości kanału czy liczbie spatial streams nie wystarcza do optymalnego rozdzielania ramek.
Potrzebna jest ocena warunków MAC oraz możliwości rzeczywistej realizacji transmisji.
Trzy różne cele algorytmu rozdzielania ruchu
W zależności od zastosowania urządzenie może próbować osiągnąć różne cele.
Pierwszym jest maksymalizacja przepustowości.
W takim przypadku ważne jest efektywne wykorzystanie dostępnego airtime na obu łączach. System może dążyć do równomiernego obciążenia zasobów, ale niekoniecznie do wysyłania tej samej liczby ramek na każdym kanale.
Drugim celem jest minimalizacja opóźnienia.
Tutaj istotniejsze może być skierowanie ramki na łącze, które najwcześniej uzyska możliwość transmisji, nawet jeśli jego nominalna szybkość jest niższa.
Trzecim celem jest ograniczanie zmienności opóźnienia, czyli jitteru.
Dla niektórych aplikacji bardziej wartościowe są przewidywalne czasy dostarczenia niż sporadyczne osiąganie bardzo wysokiej szybkości.
Te cele nie zawsze są zgodne.
Algorytm zoptymalizowany pod maksymalną przepustowość może zachowywać się inaczej niż algorytm preferujący małe, regularne opóźnienia.
MLO nie definiuje jednej uniwersalnej odpowiedzi na pytanie, który kanał jest najlepszy. Daje architekturę pozwalającą wykorzystać wiele łączy, a sposób podejmowania wielu decyzji zależy od implementacji.
A co z retransmisją na drugim łączu?
Wyobraźmy sobie, że ramka została skierowana na Link 1, ale jej transmisja nie zakończyła się sukcesem.
Czy można spróbować ponownie na Link 2?
Z punktu widzenia architektury wielołączowej taka możliwość jest interesująca, ponieważ drugi kanał może mieć inne warunki radiowe i inny poziom obciążenia.
Nie należy jednak zakładać, że każda implementacja MLO automatycznie przenosi każdą nieudaną transmisję na inne łącze.
W grę wchodzą zasady mapowania TID, obsługi retransmisji, dostępności zasobów oraz ograniczenia urządzenia.
Co więcej, samo przeniesienie transmisji może nie przynieść korzyści, jeśli drugi kanał jest zajęty albo wymaga dodatkowych operacji koordynacyjnych.
W praktyce najważniejsze jest więc nie to, czy system potrafi wybrać inny kanał, lecz czy taka decyzja rzeczywiście skróci czas skutecznego dostarczenia danych.
STR, NSTR i eMLSR zmieniają zasady planowania
W poprzednim artykule omówiliśmy trzy istotne pojęcia związane z możliwościami sprzętowymi MLO: STR, NSTR i eMLSR.
Teraz widać, dlaczego mają one bezpośredni wpływ na rozdzielanie ruchu.
W konfiguracji STR odpowiednio wyposażone urządzenie może realizować określone operacje nadawania i odbioru równocześnie na różnych łączach.
Pozwala to wykorzystać większą niezależność kanałów.
W konfiguracji NSTR pewne kombinacje jednoczesnego nadawania i odbioru są ograniczone, na przykład z powodu niewystarczającej izolacji radiowej.
Algorytm planowania musi wtedy uwzględniać zależności pomiędzy aktywnościami obu łączy.
Z kolei eMLSR pozwala korzystać z wielu łączy przy ograniczonych zasobach radiowych, ale wymaga koordynacji przełączania aktywnej obsługi transmisji.
Oznacza to, że nawet jeśli dwa kanały są wolne, urządzenie nie zawsze może wykorzystać je równocześnie.
Decyzja o wyborze łącza nie może ignorować fizycznych możliwości układu radiowego.
To właśnie miejsce, w którym algorytmy MAC spotykają się z ograniczeniami RF i architektury chipu.
Dlaczego optymalny scheduler nie istnieje w oderwaniu od sprzętu?
Wyobraźmy sobie dwa urządzenia Wi-Fi 7.
Pierwsze ma rozbudowaną architekturę wieloradiową, umożliwiającą znaczną niezależność transmisji na dwóch łączach.
Drugie jest kompaktowym urządzeniem mobilnym, w którym część zasobów radiowych jest współdzielona.
Oba mogą obsługiwać MLO, ale optymalny sposób kierowania ruchu będzie inny.
W pierwszym przypadku możliwe może być rzeczywiste równoległe wykorzystanie dwóch kanałów.
W drugim nadmiernie częste przełączanie może generować dodatkowy koszt czasowy i energetyczny.
Dochodzi jeszcze pobór energii.
Utrzymywanie aktywności wielu torów radiowych może zwiększać zużycie prądu. W urządzeniach zasilanych akumulatorowo algorytm może więc uwzględniać nie tylko przepustowość i opóźnienie, ale również efektywność energetyczną.
To ważny szczegół: najlepsza decyzja radiowa nie zawsze jest najlepszą decyzją dla całego urządzenia.
Dlaczego MLO nie przypomina zwykłego load balancingu?
Na poziomie ogólnej idei MLO można porównać do równoważenia obciążenia pomiędzy dwoma połączeniami.
Ale ta analogia ma ograniczenia.
W klasycznych rozwiązaniach sieciowych rozdzielanie ruchu może odbywać się na poziomie pakietów IP lub całych przepływów.
MLO działa w architekturze Wi-Fi, gdzie znaczenie mają również ramki MAC, dostęp do medium, agregacja, potwierdzenia, retransmisje i numery sekwencyjne.
Dodatkowo dwa łącza radiowe mogą korzystać z tych samych zasobów sprzętowych i podlegać ograniczeniom wzajemnej pracy.
To sprawia, że MLO nie jest po prostu odpowiednikiem podłączenia dwóch kabli Ethernet do jednego komputera.
W Wi-Fi każda ścieżka transmisji ma zmienny czas dostępu do medium, a samo radio jest elementem aktywnie uczestniczącym w decyzjach o możliwości nadawania.
Co widzi użytkownik, a co musi obsłużyć układ scalony?
Z punktu widzenia użytkownika MLO może objawiać się wyższą przepustowością, bardziej stabilnym działaniem aplikacji lub mniejszymi opóźnieniami w odpowiednich warunkach.
Użytkownik nie musi widzieć osobnych połączeń dla każdego wykorzystywanego łącza.
Wewnątrz urządzenia sytuacja jest znacznie bardziej skomplikowana.
System musi uwzględniać aktualną dostępność kanałów, obsługę TID, numerację sekwencyjną, potwierdzenia, retransmisje, buforowanie oraz ograniczenia jednoczesnej pracy radii.
Część tych funkcji może być realizowana sprzętowo, część przez firmware i inne elementy stosu sterowania urządzeniem.
Podział zależy od konkretnej architektury chipsetu.
Nie chodzi jednak o to, aby cały system wykonywał jak najwięcej obliczeń.
Chodzi o to, aby podejmował decyzje wystarczająco szybko, bez wprowadzania narzutu większego niż korzyść z wykorzystania dodatkowego łącza.
Największa zaleta MLO jest jednocześnie jego największym wyzwaniem
Jedno łącze radiowe upraszcza wiele decyzji.
Wszystkie ramki danego ruchu przechodzą przez ten sam kanał, więc system nie musi stale rozstrzygać, która z kilku ścieżek będzie korzystniejsza.
MLO daje większą elastyczność, ale wprowadza dodatkowe zmienne.
Teraz liczy się nie tylko to, jak szybko potrafi nadawać każde radio.
Liczy się również to, kiedy może rozpocząć transmisję, jak długo zajmie obsługa kolejki, jakie jest ryzyko retransmisji i czy wcześniejsze dostarczenie części ramek rzeczywiście przyspieszy przekazanie danych dalej.
Dlatego wydajność MLO nie wynika automatycznie z liczby aktywnych łączy.
Wynika z tego, jak dobrze urządzenie potrafi zarządzać nimi jako jednym systemem.
Dwa kanały mogą zwiększyć przepustowość. Mogą również ograniczyć czas oczekiwania na dostęp do medium.
Ale źle dobrany sposób rozdzielania ruchu może prowadzić do nierównomiernego obciążenia, dodatkowego buforowania i większej zmienności opóźnienia.
I właśnie tu pojawia się temat, który zasługuje na osobny artykuł.
Dlaczego dwa kanały mogą zmniejszyć latency, ale w pewnych sytuacjach również je zwiększyć?
W kolejnym odcinku naszej serii przyjrzymy się MLO z perspektywy czasu: opóźnieniom, jitterowi, retransmisjom i temu, dlaczego najszybsza droga radiowa nie zawsze prowadzi do najszybszego dostarczenia danych.